دادهها مصنوعی و بازتولیدپذیرند (بذر ثابت) · ساختار دامنه از پلتفرم اینمسیر الگوبرداری شده
۱ صورت مسئله و ذینفعان
چکیده
این پروژه یک پلتفرم آموزش آنلاین را مثل یک کارخانه میبیند: هر دوره یک خط تولید با ایستگاههای پشتسرهم؛ رهاکردن دوره ضایعات؛ سؤالِ معیوبِ آزمون دوبارهکاری؛ و صندلیِ خالیِ جلسه ظرفیتِ هدررفته. با این قاب، سامانه بهجای رسمِ نمودارِ خام، خودش تشخیص میدهد: خروجیِ اصلی یک فهرستِ اولویتدار از ناکارآمدیهاست که هر سطرش سه چیز دارد — شاهدِ عددی، علت، و اثرِ ریالیِ تخمینی.
۱.۱. مسئله
پلتفرمهای آموزش آنلاین دادهی فراوان تولید میکنند و تصمیمِ کم. گزارشهای متعارف به «چند نفر ثبتنام کردند» و «چقدر فروش داشتیم» ختم میشوند؛ این اعداد وضعیت را میگویند ولی کارِ بعدی را نه. مسئلهی این پروژه دقیقاً همین شکاف است:
از میانِ هزاران رویدادِ ثبتشده، کدام چند ناکارآمدی بیشترین پول را میسوزانند، شاهدِ عددیشان چیست، و اقدامِ مشخصِ هفتهی آینده کدام است؟
۱.۲. چرا قابِ مهندسی صنایع
یک دورهٔ آموزشی از نظر ساختاری با یک خط تولید یکی است: ورودی (ثبتنام)، ایستگاههای متوالی (جلسهها)، بازرسی (آزمون)، و خروجی (گواهی). این تشابه چهار سنجهٔ کلاسیکِ صنایع را مستقیماً قابلاستفاده میکند:
سنجه
در این دامنه یعنی چه
گلوگاه (TOC)
جلسهای که بیشترین ریزش را میسازد؛ ظرفیتِ کلِ خط را همان تعیین میکند.
ضایعات (Scrap)
ثبتنامی که به گواهی نمیرسد؛ هزینهاش پرداخت شده ولی ارزشی تحویل نشده.
دوبارهکاری (Rework)
سؤالی با ضریب تمیزِ منفی؛ نمره را خراب میکند و بازآزمون میسازد.
بهرهبرداری
صندلیِ خالیِ جلسه؛ منتور حاضر است ولی ظرفیتش مصرف نمیشود.
۱.۳. ذینفعان
نقش
پرسشِ اصلی
تصمیمی که میگیرد
مدیر
پول کجا برمیگردد و کجا میسوزد؟
بودجهی بازاریابی، حذف یا بازسازی دوره
کارشناس عملیات
کدام جلسه ریزش میسازد؟
بازطراحی محتوا، بازآموزی منتور
دانشآموز و خانواده
کجا عقبم و چقدر پیشرفت کردهام؟
برنامهی مطالعه، انتخاب دورهٔ بعدی
پشتیبانی
کدام درخواست از SLA گذشته؟
اولویتدهی به صف تیکت
۲ مدل داده و ERD
۲.۱. اصولِ طراحی
هیچ حقیقتی دوبار ذخیره نمیشود. نرخ تکمیل، درآمد و ریزش هیچکدام ستون نیستند؛ همه از رویدادهای خام محاسبه میشوند. یعنی داده هرگز با خودش ناسازگار نمیشود.
قید در پایگاه داده، نه در برنامه. ۶۵ قید CHECK جلوی دادهی بیمعنا را میگیرد — نمرهی منفی، پایان قبل از شروع، درصدِ بالای صد.
زمان محلی است. پایگاه داده روی Asia/Tehran تنظیم شد؛ وگرنه «جلسهی ۹ صبح» در گزارشها ۴:۳۰ بامداد دیده میشد.
26
جدول
43
کلید خارجی
65
قید CHECK
16
ویوی تحلیلی
۲.۲. نمودار ERD
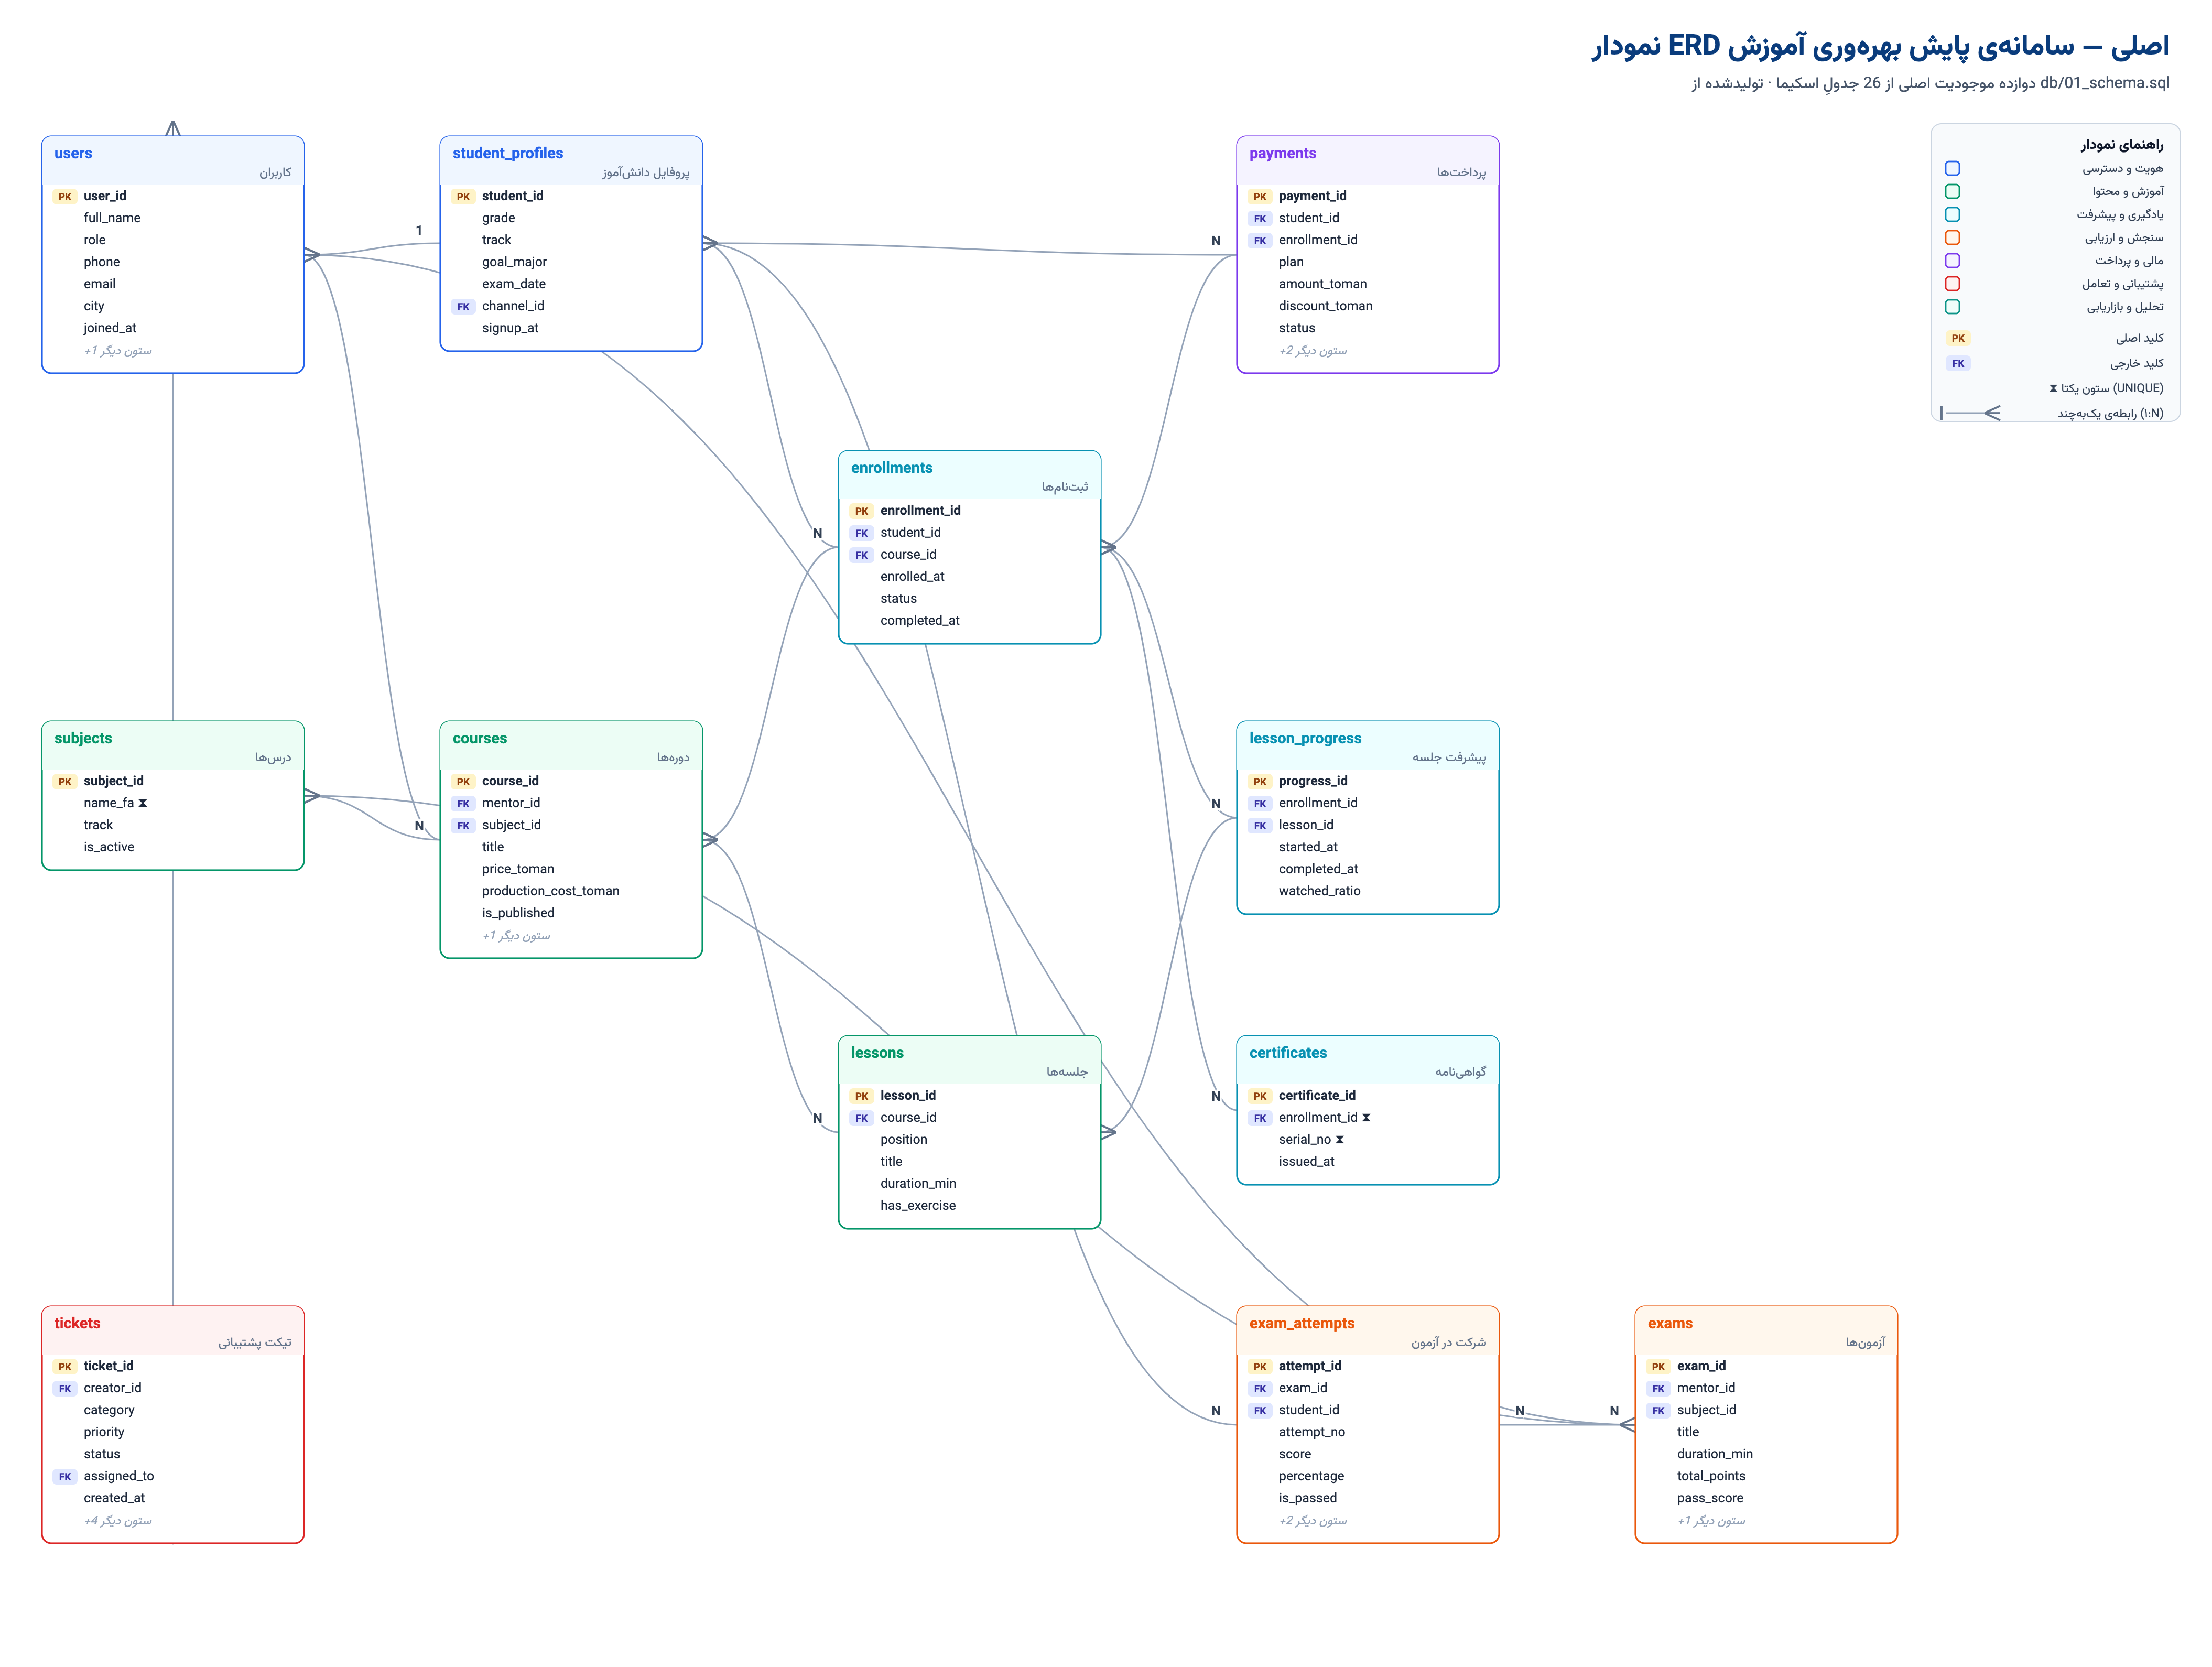
نمودارِ زیر دوازده موجودیتِ اصلیِ سامانه را نشان میدهد — همان مسیری که کسبوکار از آن میگذرد:
از کاربر و پروفایل دانشآموز تا ثبتنام، پیشرفت جلسه، سنجش، پرداخت و پشتیبانی. در هر جعبه
نامِ جدول، برچسبِ فارسی، کلیدِ اصلی (PK)، کلیدهای خارجی
(FK) و ستونهای یکتا مشخصاند؛ روی هر خط، کاردینالیتیِ دو سرِ رابطه
(1 و N) نوشته شده و پایانهٔ سهشاخه سمتِ چند را نشان میدهد.
نمودار ERD اصلی — دوازده موجودیتِ کلیدی، با کلید اصلی، کلید خارجی و کاردینالیتی.
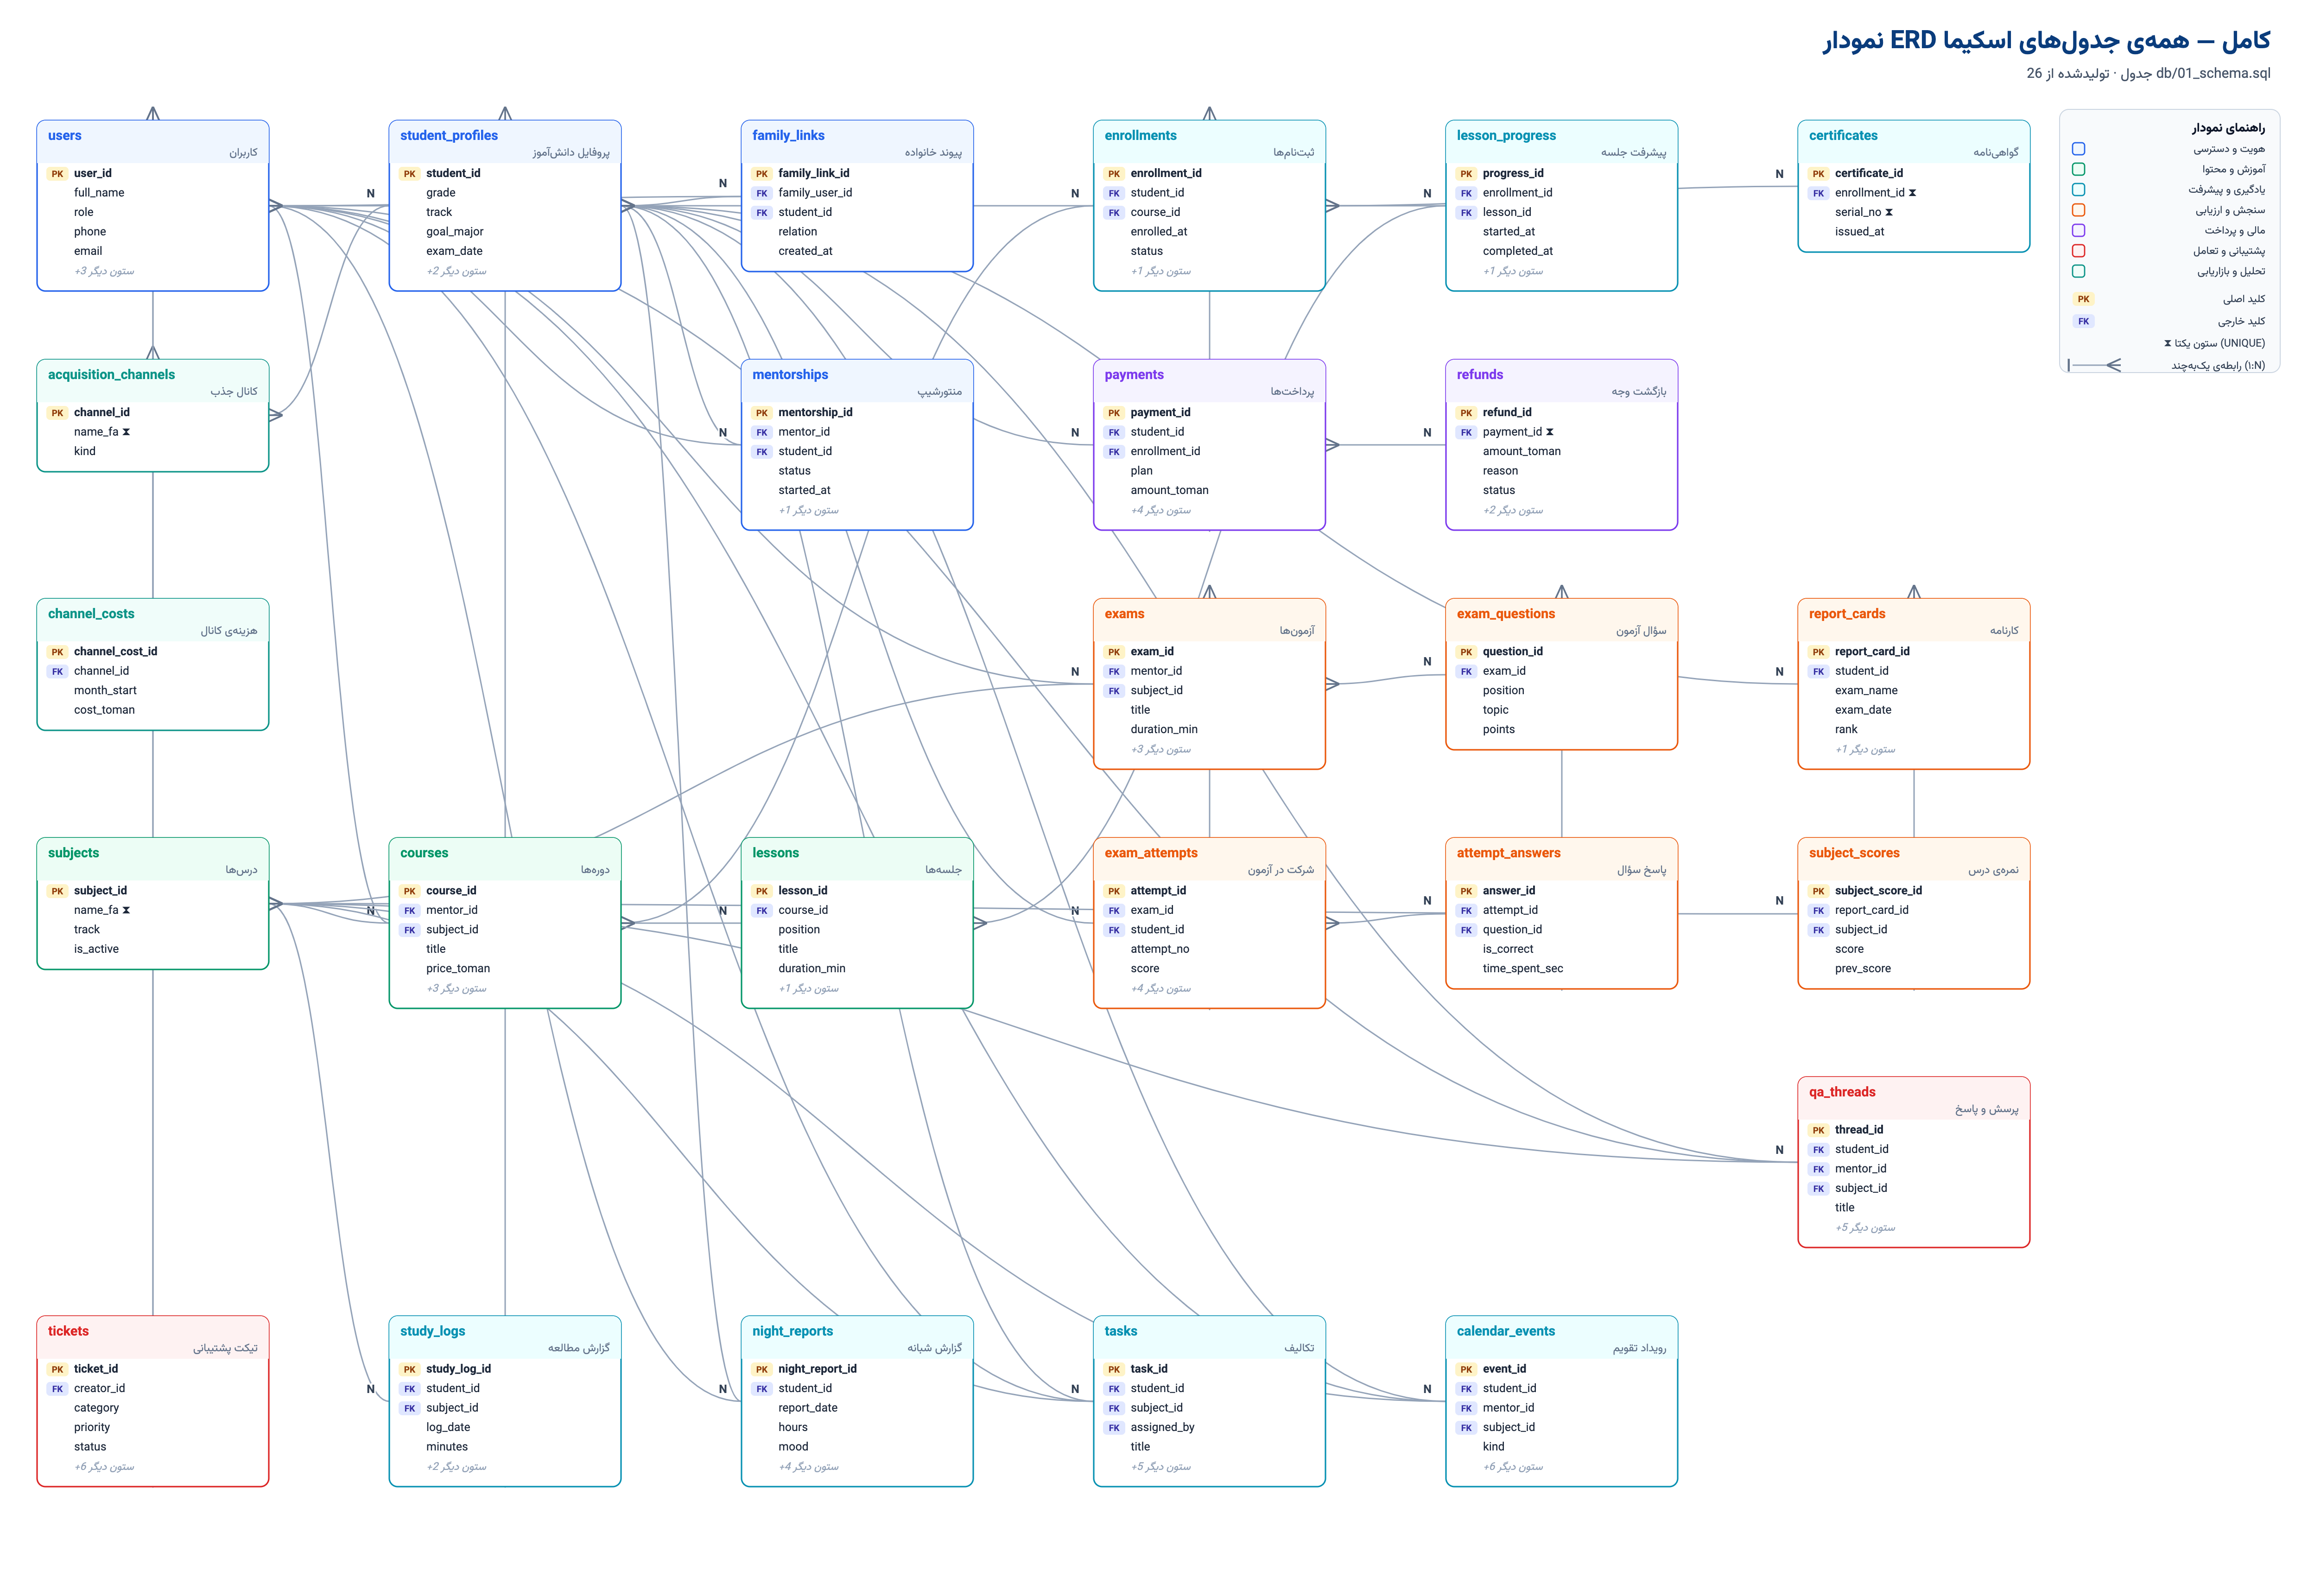
نمودار از روی اسکیما ساخته میشود، نه با دست
هر دو نمودارِ این بخش خروجیِ اسکریپت docs/erd/generate_erd.py هستند
که مستقیماً db/01_schema.sql را میخواند و جدولها، کلیدها و روابط را استخراج میکند.
اگر اسکیما تغییر کند، اجرای دوبارهٔ اسکریپت نمودار را همگام میکند؛ و اگر جدولی در چیدمان باشد که در اسکیما نیست،
اسکریپت خطا میدهد. یعنی نمودار هیچوقت از پایگاه داده جدا نمیافتد — اتفاقی که برای
ERDهای دستی رایج است.
نمودار ERD کامل — هر 26 جدولِ اسکیما با 43 کلید خارجی.
۲.۳. روابطِ اصلی و معنایِ کسبوکاریشان
رابطه
کاردینالیتی
قاعدهٔ کسبوکار
users → student_profiles
1:1
کلید اصلیِ پروفایل خودش کلید خارجی است، پس رابطه اجباراً یکبهیک است
courses → lessons
1:N
دوره از چند جلسهٔ مرتب ساخته شده — «ایستگاههای خط تولید»
enrollments → lesson_progress
1:N
قلبِ محاسبهٔ قیفِ ریزش
enrollments → certificates
1:1
گواهی حداکثر یکی، با قید UNIQUE
exams → exam_attempts
1:N
attempt_no > 1 یعنی دوبارهکاری
exam_attempts → attempt_answers
1:N
پایهٔ محاسبهٔ ضریبِ تمیزِ سؤال
payments → refunds
1:1
هر پرداخت حداکثر یک بازگشتِ وجه
users → tickets
1:N
رابطهٔ دوگانه: یک بار creator_id، یک بار assigned_to
جدول attempt_answers پاسخِ تکتکِ سؤالها را نگه میدارد، نه فقط نمرهٔ نهایی را. این باعثِ بزرگشدنِ جدول شد (54,080 رکورد) ولی بدون آن، تحلیل سؤال ممکن نبود — و همان تحلیل است که یکی از پنج یافتهٔ اصلی را میسازد. جزئیاتی که ذخیره نکنی، تحلیلی است که هرگز نخواهی داشت.
۳ تولید دادهٔ مصنوعی
داده با یک اسکریپت پایتونِ قطعی تولید شد: بذر ثابت (seed = 1405)، بازهٔ ۲۱ اسفند ۱۴۰۳ تا ۱۹ مرداد ۱۴۰۵. هر اجرا دقیقاً همان 232,258 رکورد را میسازد.
2,937
ثبتنام
56,979
لاگ مطالعه
54,080
پاسخ سؤال
2,601
تیکت
۳.۱. دستورهای تولید داده — «با چه منطقی به این داده رسیدیم»
برای اینکه مسیرِ رسیدن به داده قابلِ بازرسی باشد، مشخصاتی که به مولد داده شد در ادامه آمده است.
یک تذکر صادقانه
داده با مدل زبانی تولید نشده؛ با یک اسکریپت پایتونِ قطعی ساخته شده است.
آنچه «دستور» نامیده میشود همان مشخصاتِ تولید است. دلیلِ این انتخاب قطعیت است: مدل زبانی هر بار
دادهٔ متفاوت میدهد و رعایتِ قیدهای FOREIGN KEY و
CHECK را تضمین نمیکند.
دستور رفتار مطالعه
احتمالِ ثبتِ مطالعه از پشتکارِ ثابتِ دانشآموز میآید، جمعهها کم میشود و نزدیکِ کنکور بالا میرود:
ریزش فقط در لحظهٔ «شروعِ جلسه» رخ میدهد؛ جلسهٔ طولانیِ بدونِ تمرین احتمالِ شروع را تقریباً نصف میکند — همان گلوگاهِ کاشتهشده:
p_start = 0.96 if position == 1 else keep_base
if duration >= 78 and not has_exercise:  p_start *= 0.55
elif duration >= 60:                     p_start *= 0.93
watched_ratio = clamp(betavariate(8, 1.2), 0.05, 1.0)
completed     = watched_ratio >= 0.65
دستور کیفیت منتور
یک منتور عمداً ضعیف ساخته شد: کم بازبینی میکند، دیر پاسخ میدهد و امتیازِ پایین میگیرد:
p_review  = 0.35 if bad_mentor else clamp(0.70 + 0.25*(quality-1), 0.5, 0.95)
lag_hours = randint(20, 60) if bad_mentor else randint(1, 14)
rating    = randint(1, 3)   if bad_mentor else randint(3, 5)
شرحِ کامل هر پنج دستور بههمراه سطرهای متناظرِ کد در
docs/DATA.md بخش ۶ آمده است.
۳.۲. واقعنمایی: سه بارِ تنظیمِ مولد
نسخهی اول دادهٔ سازگار تولید کرد ولی باورپذیر نبود. سه اصلاح لازم شد:
مشکل
چه بود و چطور حل شد
قیفِ شکسته
حلقهٔ تولید هر بار که نسبتِ تماشا زیر 0.85 میشد کلاً میشکست، پس فقط یک گواهی صادر شد. «رهاکردنِ دوره» از «تکمیلِ جلسه» جدا شد؛ نرخ تکمیل به 13.7٪ رسید.
CAC غیرواقعی
هزینهٔ ماهانهٔ کانالها حدود پنج برابر بالا بود و CAC به 12.85 میلیون تومان میرسید. با مقیاسگذاری و وابستهکردنِ تعداد ثبتنام به پشتکارِ دانشآموز، LTV بین کانالها تنوع گرفت.
منطقهٔ زمانی
EXTRACT(hour) روی UTC کار میکرد و ساعت ۸ صبح، ۴ بامداد دیده میشد. با -c timezone=Asia/Tehran روی خودِ سرور حل شد.
۳.۳. یافتههای کاشتهشده
برای اینکه داشبورد چیزی برای کشفکردن داشته باشد، پنج ناکارآمدی عمداً در داده کاشته شد — نه بهصورت برچسب، بلکه بهصورتِ الگوی رفتاری که فقط با تحلیل پیدا میشود. هر پنج مورد بعداً با SQL مستقل راستیآزمایی شد.
۴ لایهٔ معنایی — شانزده ویوی تحلیلی
هر سه مصرفکننده (داشبورد Looker، سامانهٔ وب، چتبات) از همین شانزده ویو تغذیه میشوند. یعنی «نرخ تکمیل» فقط یک تعریف دارد و در هر سه جا همان عدد دیده میشود. اگر هر مصرفکننده کوئریِ خودش را مینوشت، سه تعریفِ کمی متفاوت پیدا میکردیم — کلاسیکترین راهِ بیاعتبارشدنِ یک داشبورد.
بهرهوریِ منتور: بهبودِ نمره به ازای هر ۱۰۰ ساعت مطالعهٔ دانشآموزانش. برخلافِ «میانگین نمره»، این سنجه منتوری را که دانشآموزانِ قوی گرفته پاداش نمیدهد.
۵ یافتهها — پنج اقدامِ برتر
این بخش خروجیِ اصلیِ پروژه است. هر سطر از ویوی v_top_actions_full میآید و همان چیزی است که در صدرِ داشبوردِ مدیر دیده میشود.
یافتهٔ ۱ — گلوگاهِ محتوا
دورهی «نکته و تست ریاضی» — جلسهی ۴. ریزش 59٪ (49 نفر) در همین یک جلسه؛ مدتش 94 دقیقه و بدون هیچ تمرینی.
اقدام: تقسیم جلسه و افزودنِ تمرین. · اثر تخمینی:8 میلیون تومان درآمدِ حفظشده.
یافتهٔ ۲ — کیفیتِ منتورینگ
منتور: حسین میرزایی. رضایت 1.77 از 5؛ نرخ بازبینی 38.3٪؛ میانگین پاسخدهی 52 ساعت. بهرهوریِ او 0.21 است در برابرِ 0.37 برای منتورهای بعدی — یعنی حدود نصف.
اقدام: بازآموزی یا بازتوزیعِ دانشآموزان. · اثر:22 دانشآموز در معرضِ ریسک.
یافتهٔ ۳ — بازدهِ بازاریابی
کانال: تبلیغات اینستاگرام. نسبت LTV/CAC برابر 1.51 در حالی که آستانهٔ متعارفِ سلامت 3 است.
اقدام: کاهش بودجه و انتقال به کانالهای پربازده. · اثر:558 میلیون تومان بودجهٔ قابلِ بازتخصیص.
کانال جذب
دانشآموز
CAC (هزار ت)
LTV/CAC
تبلیغات اینستاگرام
242
2,304
1.51
تبلیغات یوتیوب/آپارات
118
2,095
2.08
همکاری با مدارس
94
2,011
2.45
کانال تلگرام
104
987
4.70
جستوجوی گوگل
139
441
10.30
معرفی دوستان
103
293
18.81
کانالی که بیشترین دانشآموز را میآورد، کمبازدهترین هم هست. «تعداد جذب» بدونِ «هزینهٔ جذب» گمراهکننده است.
یافتهٔ ۴ — کیفیتِ سنجش
آزمون زیستشناسی — سری ۴. سه سؤال با ضریبِ تمیزِ منفی. دانشآموزِ قوی بیشتر از ضعیف غلط زده.
اقدام: بازطراحیِ سؤالهای معیوب پیش از آزمونِ بعدی. · اثر: اعتبارِ نمرهٔ 64 دانشآموز.
یافتهٔ ۵ — بهرهوریِ ظرفیت
جلسههای ساعت ۹ صبح. نرخ حضور 21.0٪ در 830 جلسه — در حالی که میانگینِ کلِ سامانه 52.5٪ است.
اقدام: جابهجاییِ جلسههای صبح به بازهٔ ۱۹ تا ۲۱. · اثر:656 جلسهٔ هدررفته.
چرا این خروجی با «داشبورد» فرق دارد
یک داشبوردِ متعارف نمودارِ «نرخ حضور بر حسب ساعت» را رسم میکند و کار را تمامشده میداند. اینجا سامانه یک قدم جلوتر میرود: خودش پایینترین ستون را پیدا میکند، فاصلهاش با میانگین را میسنجد، و آن را با تعدادِ جلسه ضرب میکند تا به عددِ قابلِ تصمیم برسد. تفاوت، تفاوتِ گزارش و تشخیص است.
۶ داشبورد Looker Studio
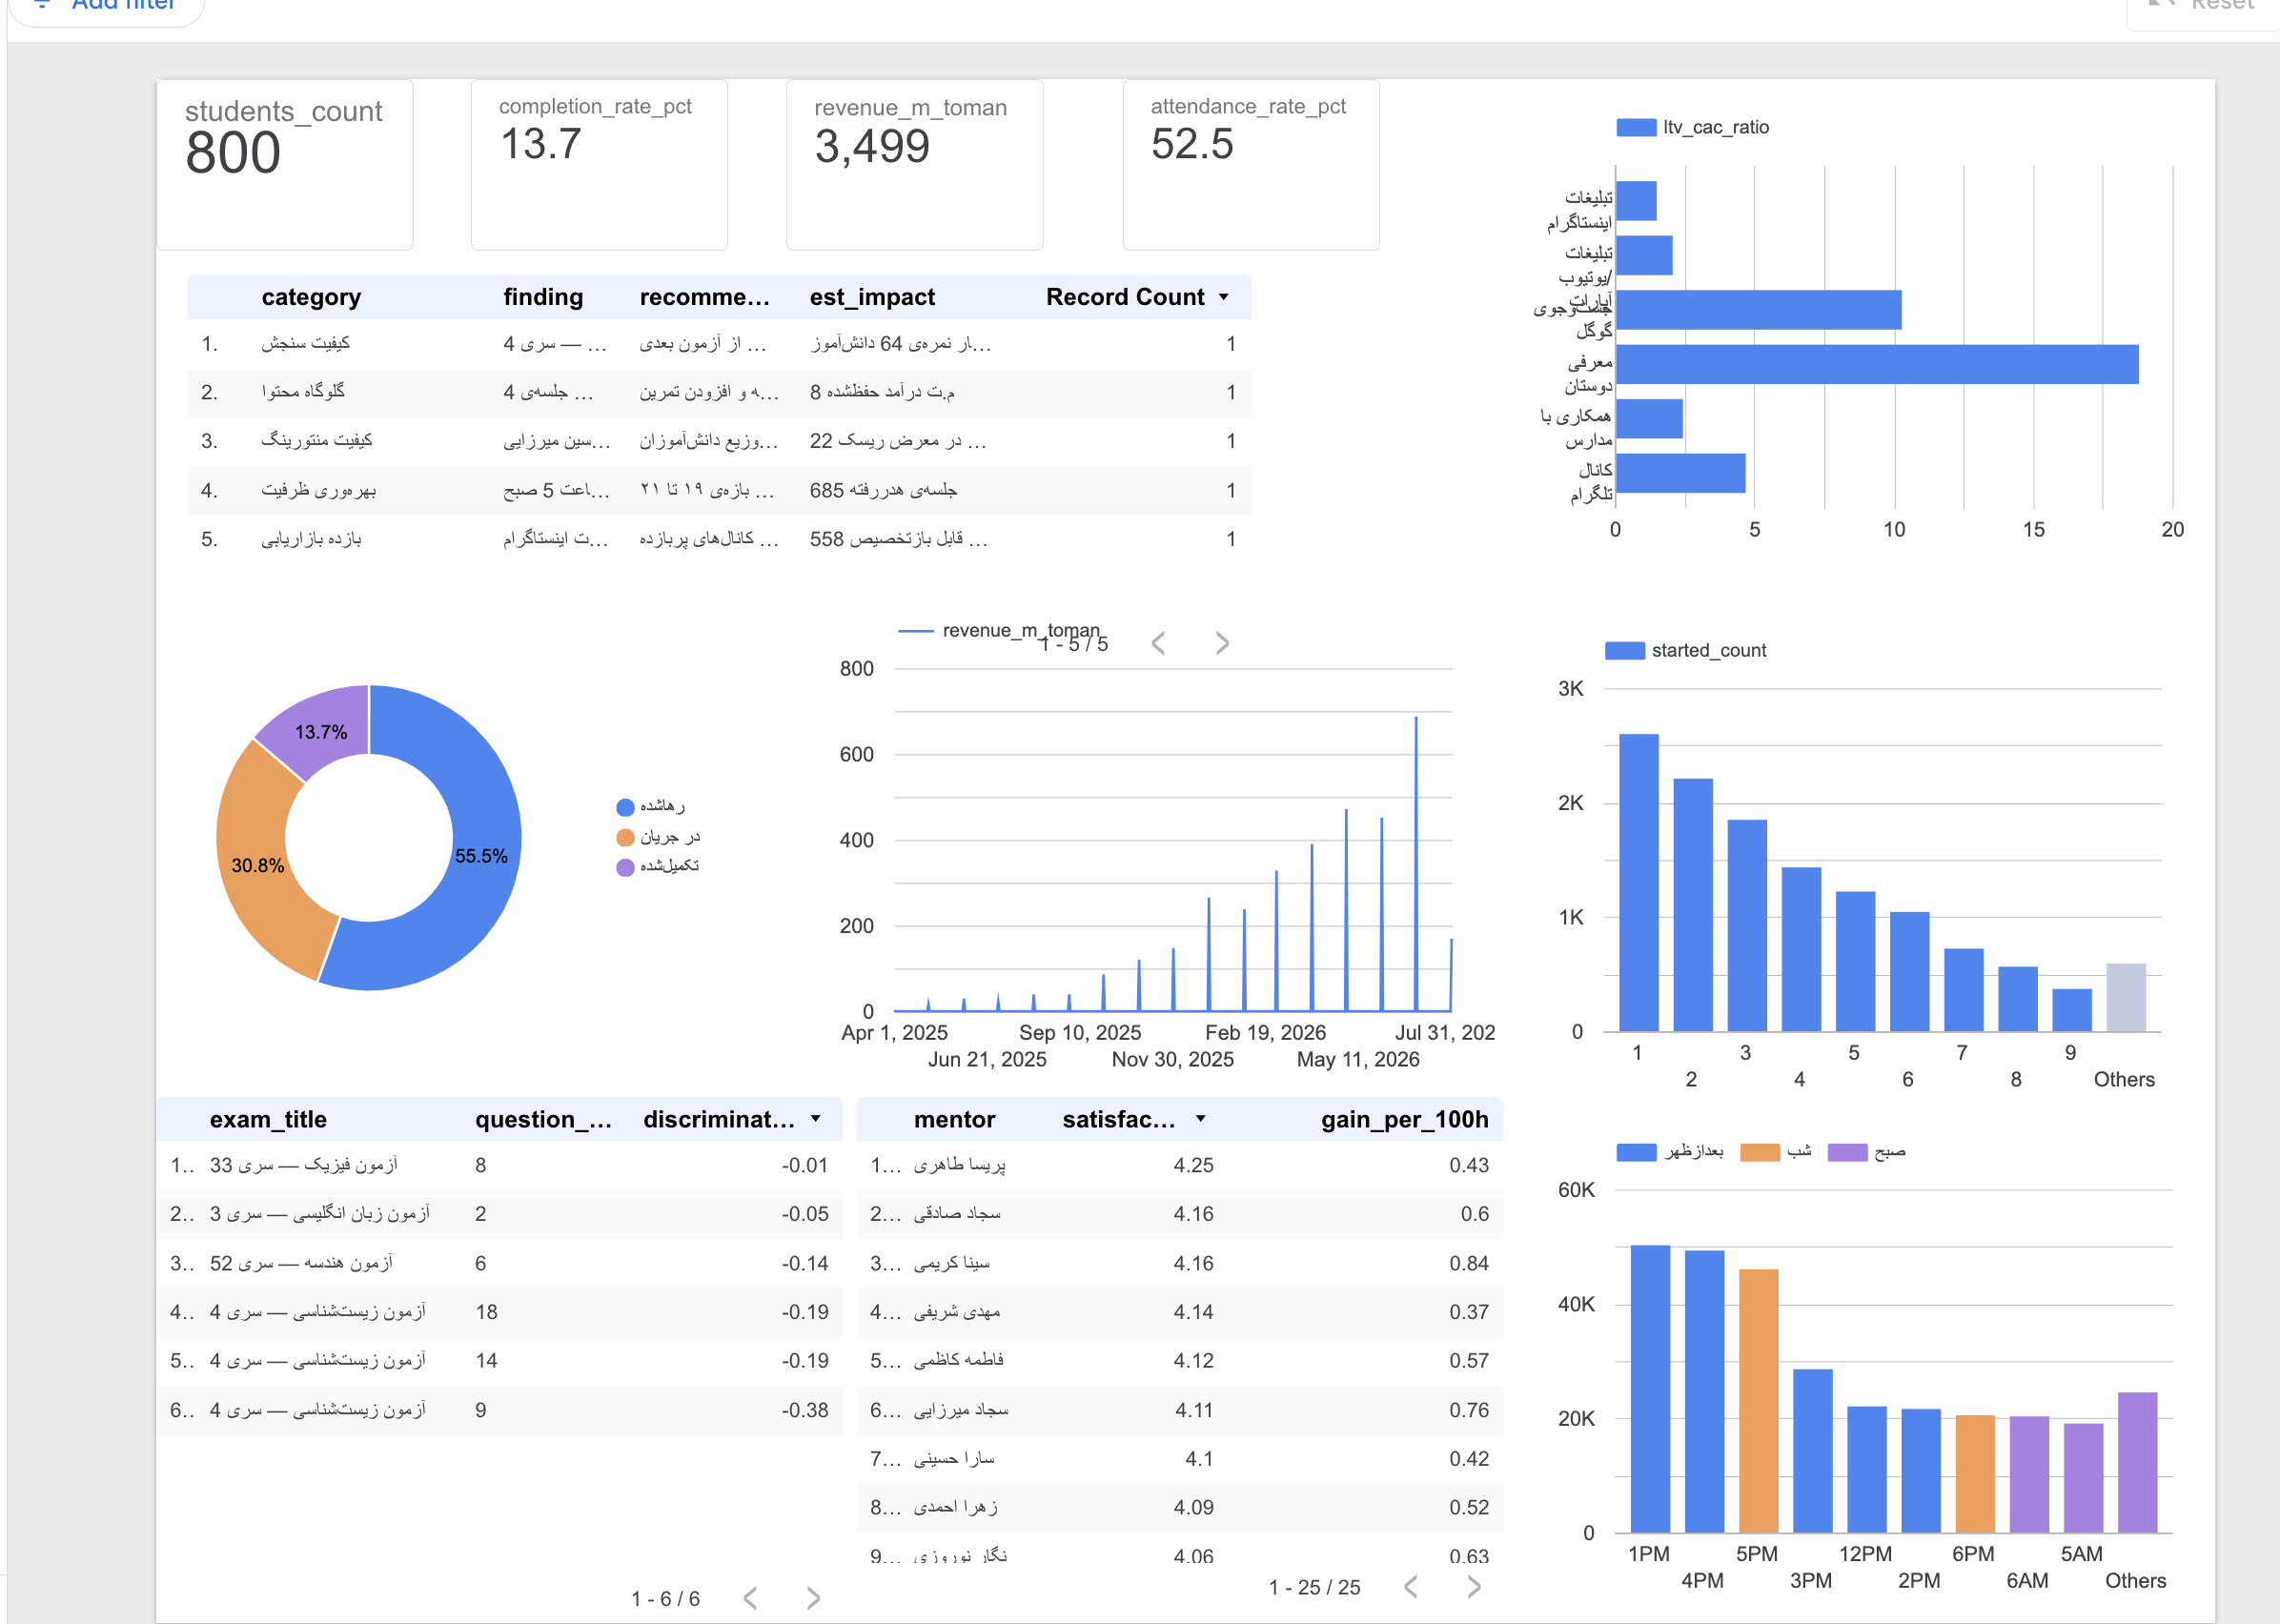
داشبورد مستقیماً به همان PostgreSQL روی سرورِ آمستردام وصل میشود — نه به یک فایلِ صادرشده. برای این کار یک نقشِ فقطخواندنی به نام looker_ro ساخته شد که فقط SELECT روی اسکیمای edu دارد؛ با پروبِ مستقیم تأیید شد که CREATE TABLE و DELETE هر دو با «permission denied» رد میشوند.
شکل ۱ — صفحهٔ ۱ داشبورد، نمای مدیر (۱۱ عنصر): چهار کارت شاخص، جدولِ پنج اقدام برتر، بازدهِ کانالها، دوناتِ وضعیت ثبتنام، قیفِ جلسهبهجلسه، تحلیل سؤال و عملکرد منتور — همه با اتصال زنده به پایگاه داده.
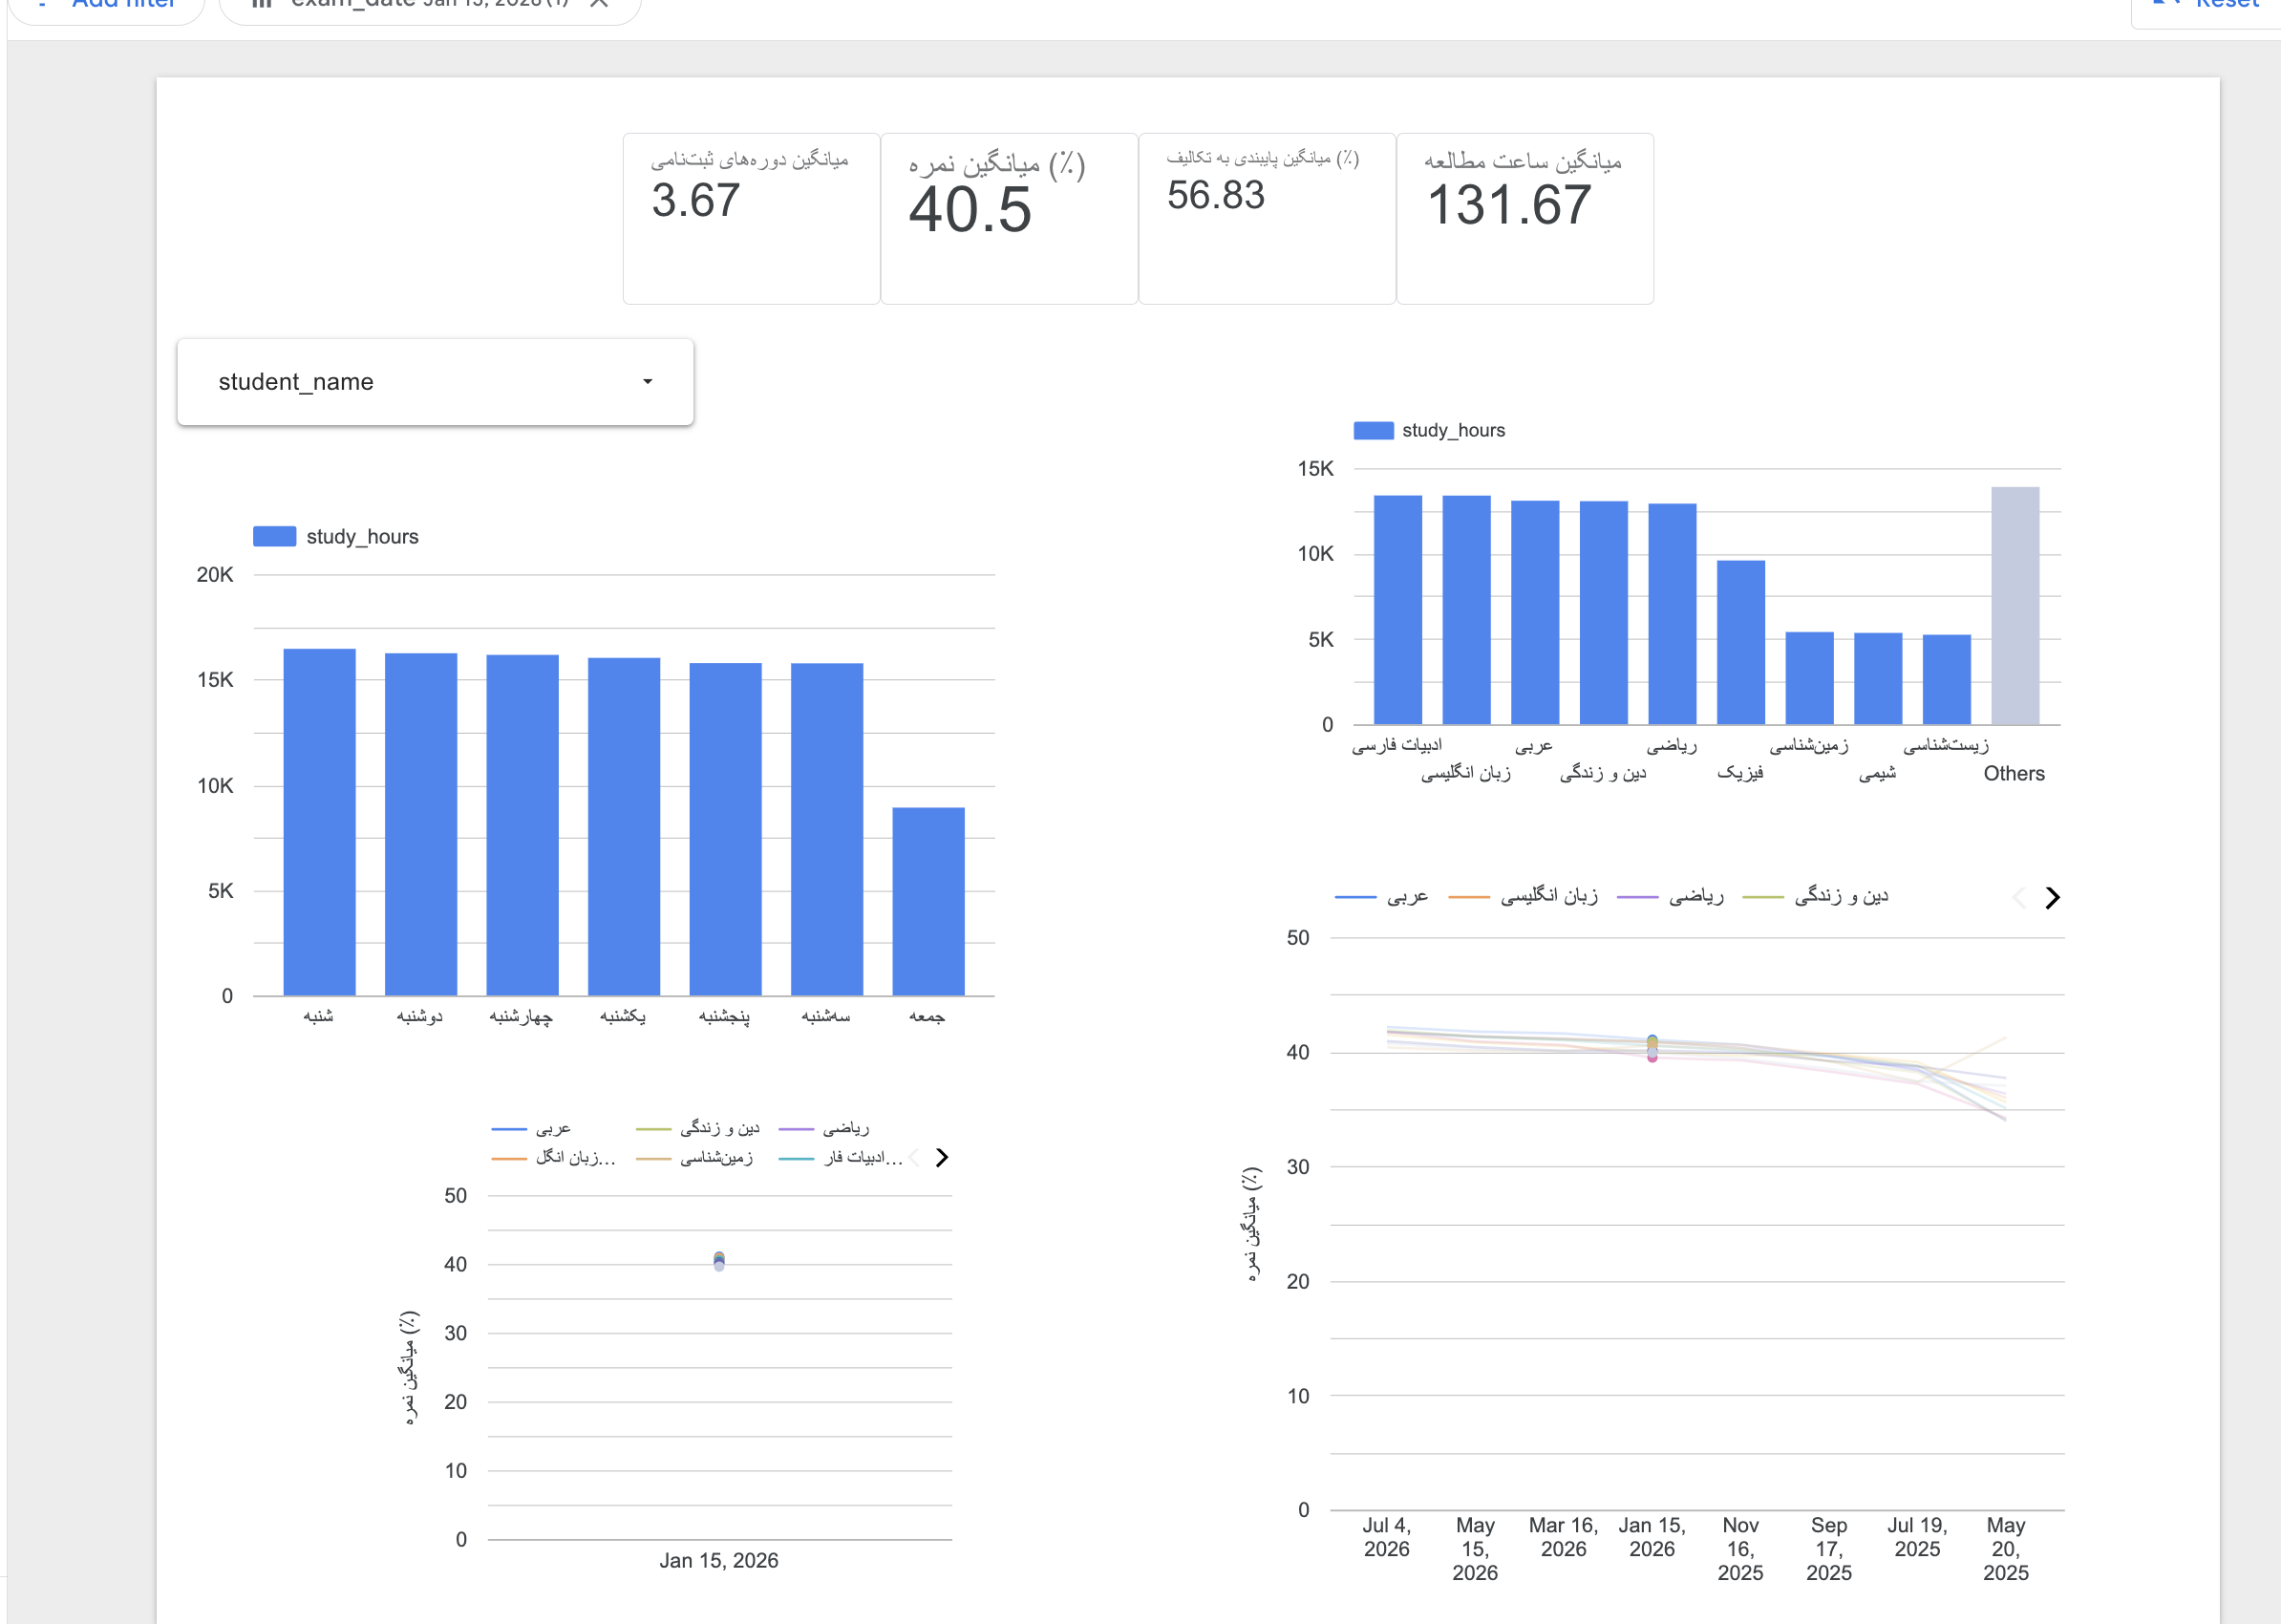
داشبورد سه صفحه دارد و در مجموع 22 عنصر؛ هر صفحه به یک ذینفع پاسخ میدهد. صفحهٔ دوم یک کنترل کشویی روی نامِ دانشآموز دارد که هر هشت عنصرش را همزمان فیلتر میکند.
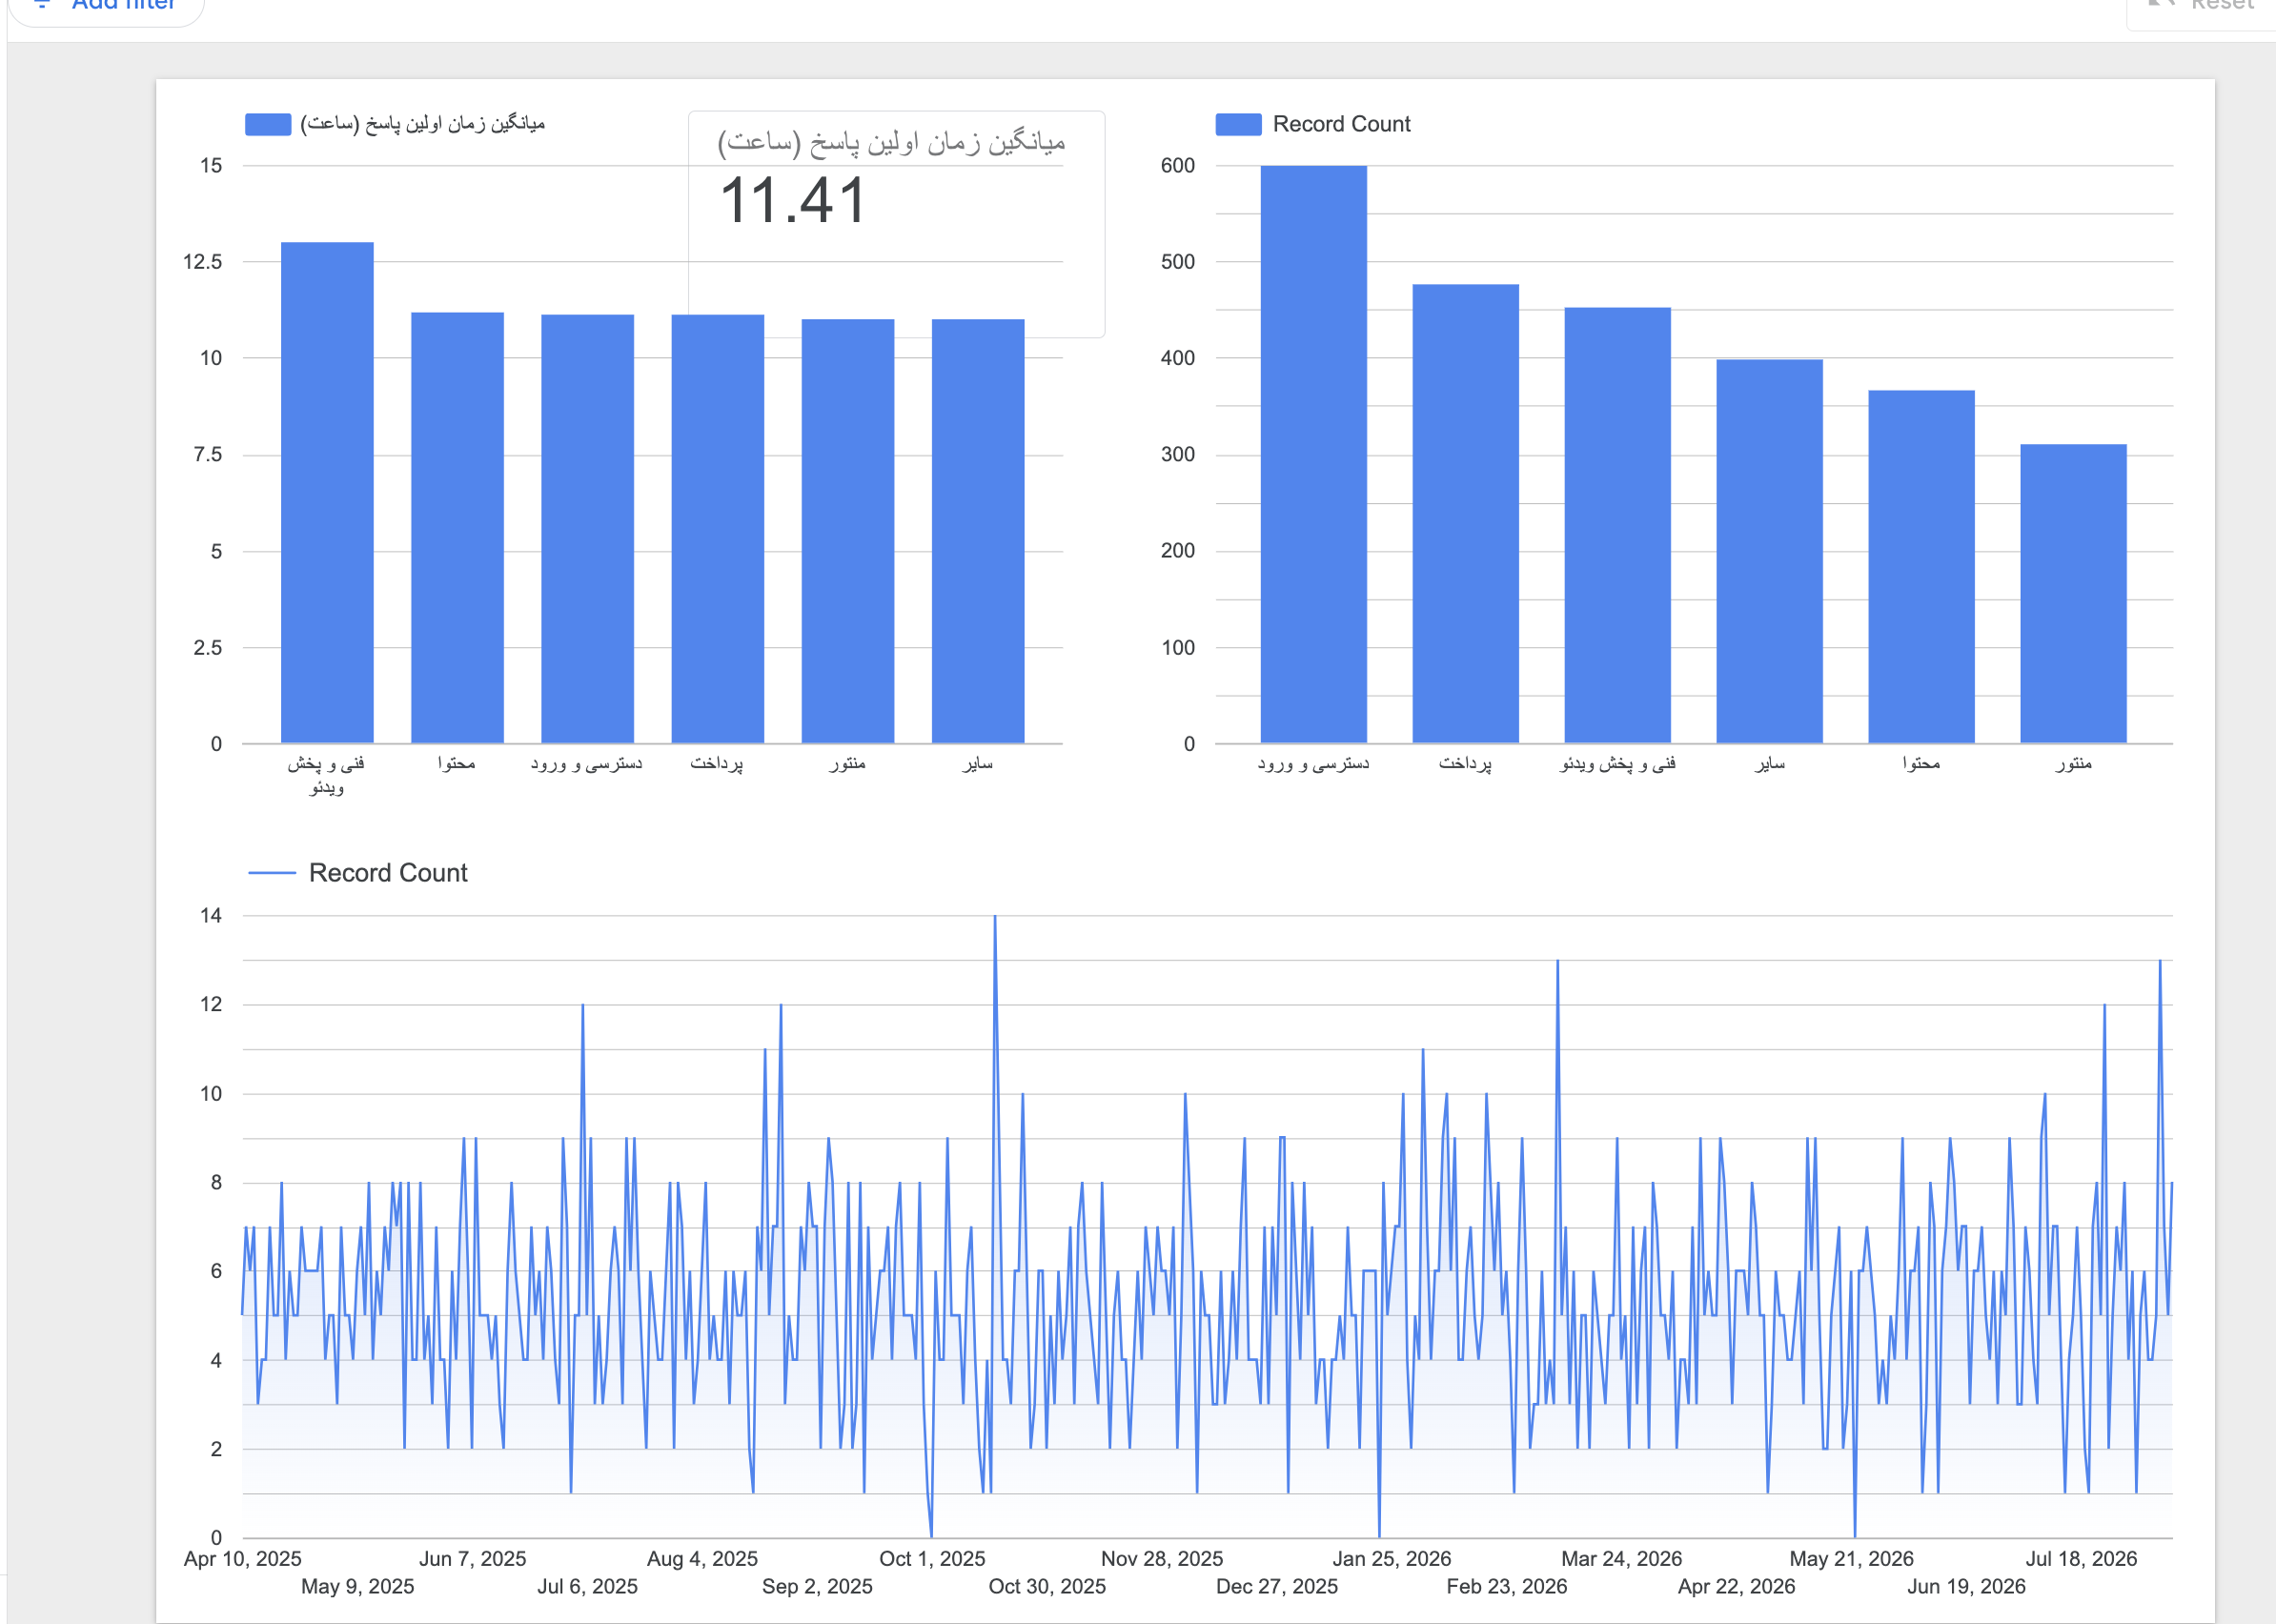
شکل ۲ — صفحهٔ ۲، دانشآموز و خانواده (۸ عنصر): کنترل کشویی انتخاب دانشآموز، چهار کارتِ میانگین (ساعت مطالعه، دورههای ثبتنامی، نمره، پایبندی به تکالیف)، سری زمانی مطالعه، مطالعه بر حسب درس و روز هفته، و روند نمره به تفکیک درس.شکل ۳ — صفحهٔ ۳، پشتیبانی و SLA (۴ عنصر): شمار تیکت، سری زمانی تیکت، تیکت بر حسب دسته، و میانگین زمانِ اولین پاسخ بر حسب دسته — همان سنجهای که ضعفِ SLA را نشان میدهد.
دو نکتهٔ عملی
یک: گزینهٔ TABLE کار نمیکند، چون ویوها در اسکیمای edu هستند و فهرستِ جدولهای Looker فقط public را نشان میدهد. باید CUSTOM QUERY انتخاب شود.
دو:Looker Studioنام ستونِ فارسی را نمیپذیرد. هر ۱۰۳ ستونِ ویوها به انگلیسی تغییر نام دادند و برچسبِ فارسی بهصورتِ نمایشی در خودِ Looker تنظیم شد.
۷ سامانهٔ وبِ سهنقشی
علاوه بر داشبوردِ Looker، یک برنامهٔ تکصفحهایِ React روی bi.packup.ir مستقر شد که از همان ویوها تغذیه میشود. دلیلِ وجودش این است که Looker Studio دو کار را نمیتواند: نوشتن در پایگاه داده (که چتبات لازم دارد)، و راستچینیِ درستِ فارسی.
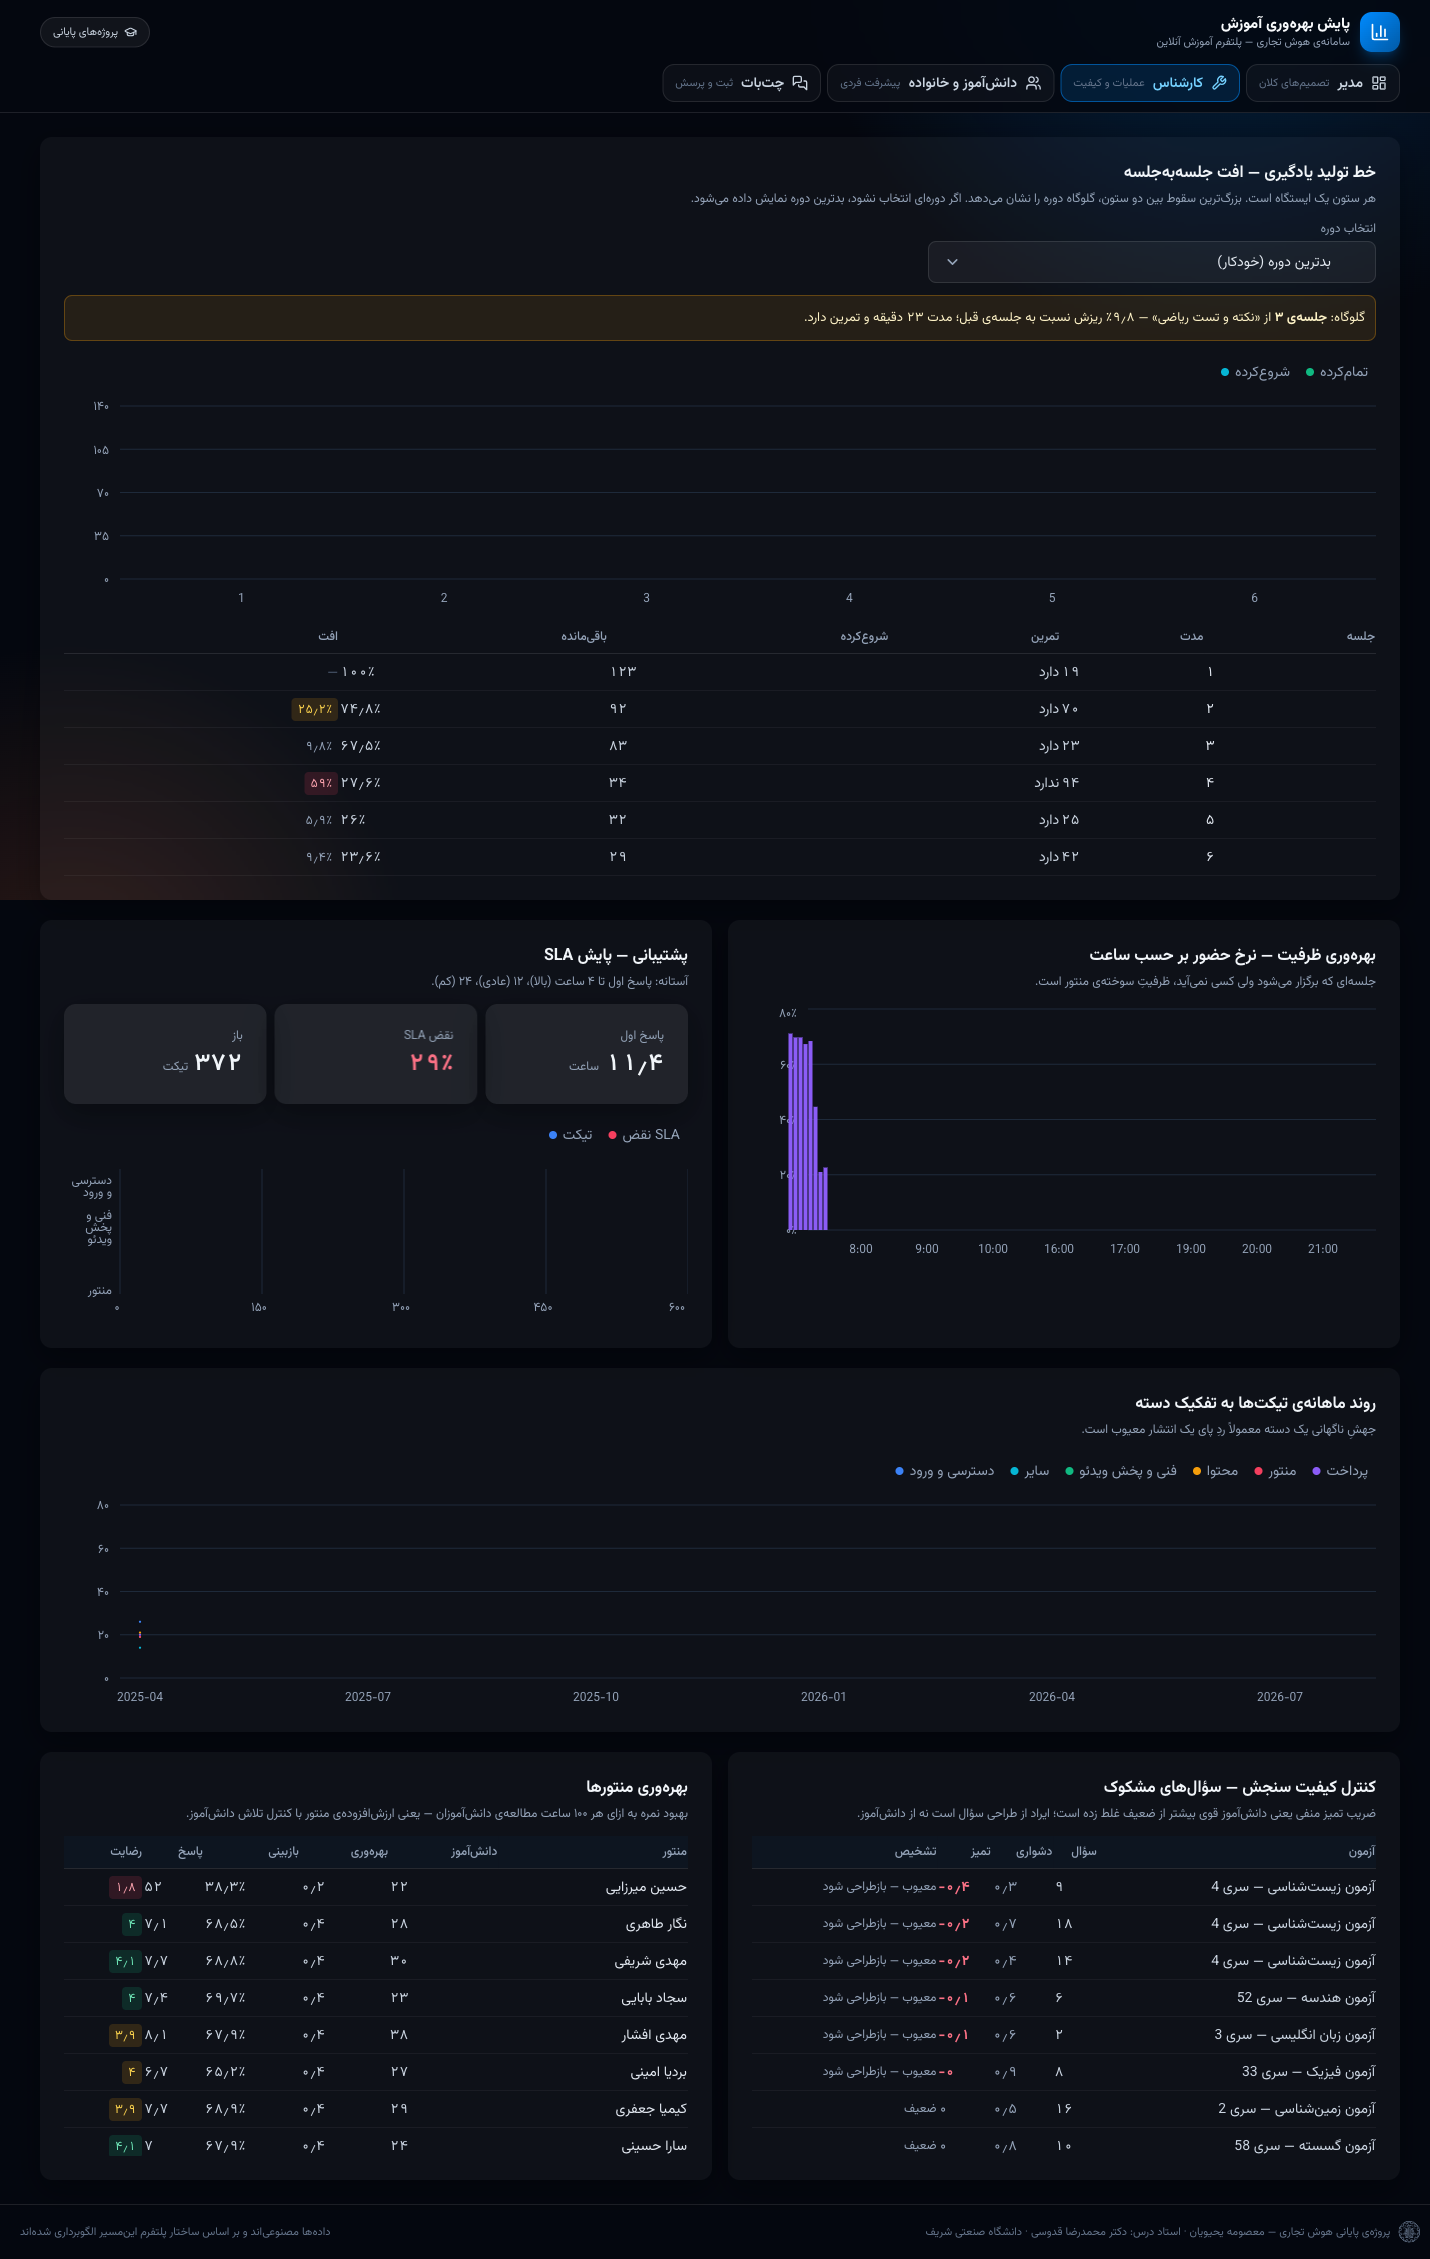
شکل ۴ — صفحهی مدیر: چهار شاخص کلان و کارتِ امضای پروژه (پنج اقدام برتر). هر ردیف یک ناکارآمدی با شاهدِ عددی، اقدام و اثرِ ریالی.شکل ۵ — صفحهی کارشناس عملیات: قیفِ جلسهبهجلسه، سؤالهای معیوبِ آزمون، عملکرد منتور و نرخ حضور بر حسب ساعت.شکل ۶ — پنل دانشآموز و خانواده: نمای ۳۶۰ درجهی یک دانشآموز — ساعت مطالعه، روند نمره و دورهها.
اشکالی که فقط با اندازهگیری پیدا شد
کامپوننتِ Card در کتابخانهٔ Tremor کلاسِ text-left را سختکد میکند. در سندِ راستبهچپ این یعنی همهٔ متنِ فارسیِ داخلِ کارت به لبهٔ چپ میچسبد. چشم این را در عرضِ کم نمیگیرد؛ با اندازهگیریِ مستقیمِ جعبهٔ متن معلوم شد: صفر پیکسل فاصله از چپ و 730 پیکسل خالی از راست. راهحل text-align: start است نه right — چون start جهت را از سند میگیرد و داخلِ بومِ چپبهراستِ نمودارها همچنان چپ میماند.
۸ چتباتِ دادهمحور
چتبات دو کارِ کاملاً متفاوت میکند: از کاربر داده میگیرد و ثبت میکند، و به مدیر پاسخِ تحلیلی با نمودار میدهد. هر دو بدونِ مدلِ زبانی پیاده شدند — منطق قاعدهمحور است و هر پاسخ از پایگاه داده میآید، نه از حافظهٔ مدل.
۸.۱. پنج لایهٔ اعتبارسنجی
قالب — ارقامِ فارسی به لاتین تبدیل میشوند؛ کدِ ملی با الگوریتمِ رقمِ کنترلی بررسی میشود، نه فقط طولش.
دامنه — مقدار باید در بازهٔ مجاز باشد (ساعت ۰ تا ۲۳، نمره ۰ تا ۲۰).
کاملبودن — هیچ فیلدِ اجباری خالی نمیماند؛ بات تا گرفتنِ آن پیش نمیرود.
تطابقِ ارجاعی — شناسهٔ دوره یا دانشآموز باید واقعاً در پایگاه داده وجود داشته باشد.
قاعدهٔ کسبوکار — بازگشت وجه فقط تا ۷ روز و با پیشرفتِ کمتر از ۲۰٪؛ تیکتِ تکراری در ۲۴ ساعت رد میشود.
شکل ۷ — پرسشِ «گلوگاه کجاست؟» در نقشِ مدیر: پاسخِ متنی بههمراهِ نمودارِ قیفِ افت درونِ همان گفتگو. نمودار سمتِ سرور انتخاب میشود و کلاینت آن را با Tremor رسم میکند.شکل ۸ — سناریوی ثبتِ تیکت در نقشِ دانشآموز: گفتگوی گامبهگام با اعتبارسنجی در هر مرحله و شمارهٔ پیگیری در پایان.
نمونهٔ اجرای واقعی (راستیآزماییشده)
تیکتِ TKT-1405-002601 واقعاً ساخته شد و وجودش در پایگاه داده تأیید شد. در تلاشِ دوم، تشخیصِ تکراری فعال شد. درخواستِ بازگشت وجه هم با دلیلِ عددی رد شد — نه با پیامِ عمومی، بلکه با ذکرِ روزِ سپریشده و درصدِ پیشرفت.
چرا قاعدهمحور و نه مدلِ زبانی
یک مدلِ زبانی میتواند عددی بسازد که وجود ندارد. در گزارشی که قرار است مبنای تصمیم باشد، این ریسک پذیرفتنی نیست. اینجا هر عدد نتیجهٔ یک کوئریِ مشخص روی ویوی مشخص است — قابلِ ردیابی و قابلِ بازتولید. هزینهاش این است که بات فقط به پرسشهای پیشبینیشده پاسخ میدهد؛ سودش این است که هیچوقت دروغ نمیگوید.
۹ راستیآزمایی و جمعبندی
هر ادعای عددیِ این گزارش با کوئریِ مستقل روی همان پایگاه داده بررسی شد. اسکریپت db/99_verify.sql هر پنج یافتهٔ کاشتهشده را دوباره پیدا میکند — یعنی زنجیرهٔ «تولید داده ← ویو ← تشخیص» سالم است.
بررسی
انتظار
نتیجه
پنج یافتهٔ کاشتهشده دوباره پیدا میشوند
هر پنج
تأیید
نقشِ looker_ro نمیتواند بنویسد
رد شدن
تأیید
اتصالِ Looker به پایگاه داده
برقرار
تأیید
تیکتِ ساختهشده در پایگاه داده هست
موجود
تأیید
تشخیصِ تیکتِ تکراری
فعال شود
تأیید
هر ۱۱ پرسشِ تحلیلی نمودار برمیگرداند
۱۱ از ۱۱
تأیید
۹.۱. محدودیتها — صادقانه
داده مصنوعی است. الگوها واقعنما تنظیم شدهاند ولی از رفتارِ واقعیِ کاربر نیامدهاند. اعدادِ اثر تخمیناند، نه اندازهگیری.
اثرِ تخمینی، علیّت را ثابت نمیکند. اینکه جلسهٔ ۴ بیشترین ریزش را دارد نشان میدهد کجا مشکل است، نه اینکه اصلاحش حتماً همان مقدار درآمد را برمیگرداند. برای آن، آزمونِ A/B لازم است.
ترافیکِ پایگاه داده رمزنگاری نشده. سرور گواهیِ TLS ندارد، پس اتصالِ Looker بدونِ SSL است. ریسک با نقشِ فقطخواندنی و مصنوعیبودنِ داده محدود شده.
چتبات فقط به پرسشهای پیشبینیشده پاسخ میدهد. این انتخابِ آگاهانه بود، ولی محدودیت است.
۹.۲. کارهای بعدی
آزمونِ A/B روی جلسهٔ گلوگاهی برای سنجشِ اثرِ واقعیِ اصلاح.
مدلِ پیشبینیِ ریزش برای هشدارِ زودهنگام، پیش از آنکه دانشآموز رها کند.
TLS روی پایگاه داده و محدودکردنِ فایروال به بازهٔ آیپیِ Looker Studio.